五条路,一张图:AI 怎么才算「学会」你的数据
上一篇《想让 AI 学会你自己的数据?》发出去的第二天早上,群里有人回了一句「这个群交流内容整理真不错」,接着话题就没停下来。中午 13:00,Jeff 在群里发了一大段文字——不是转发,是他自己敲的——把知识库、LORA、GraphRAG、思考链一路串到了 Palantir 的方法论。一分钟后,他补了一张图:
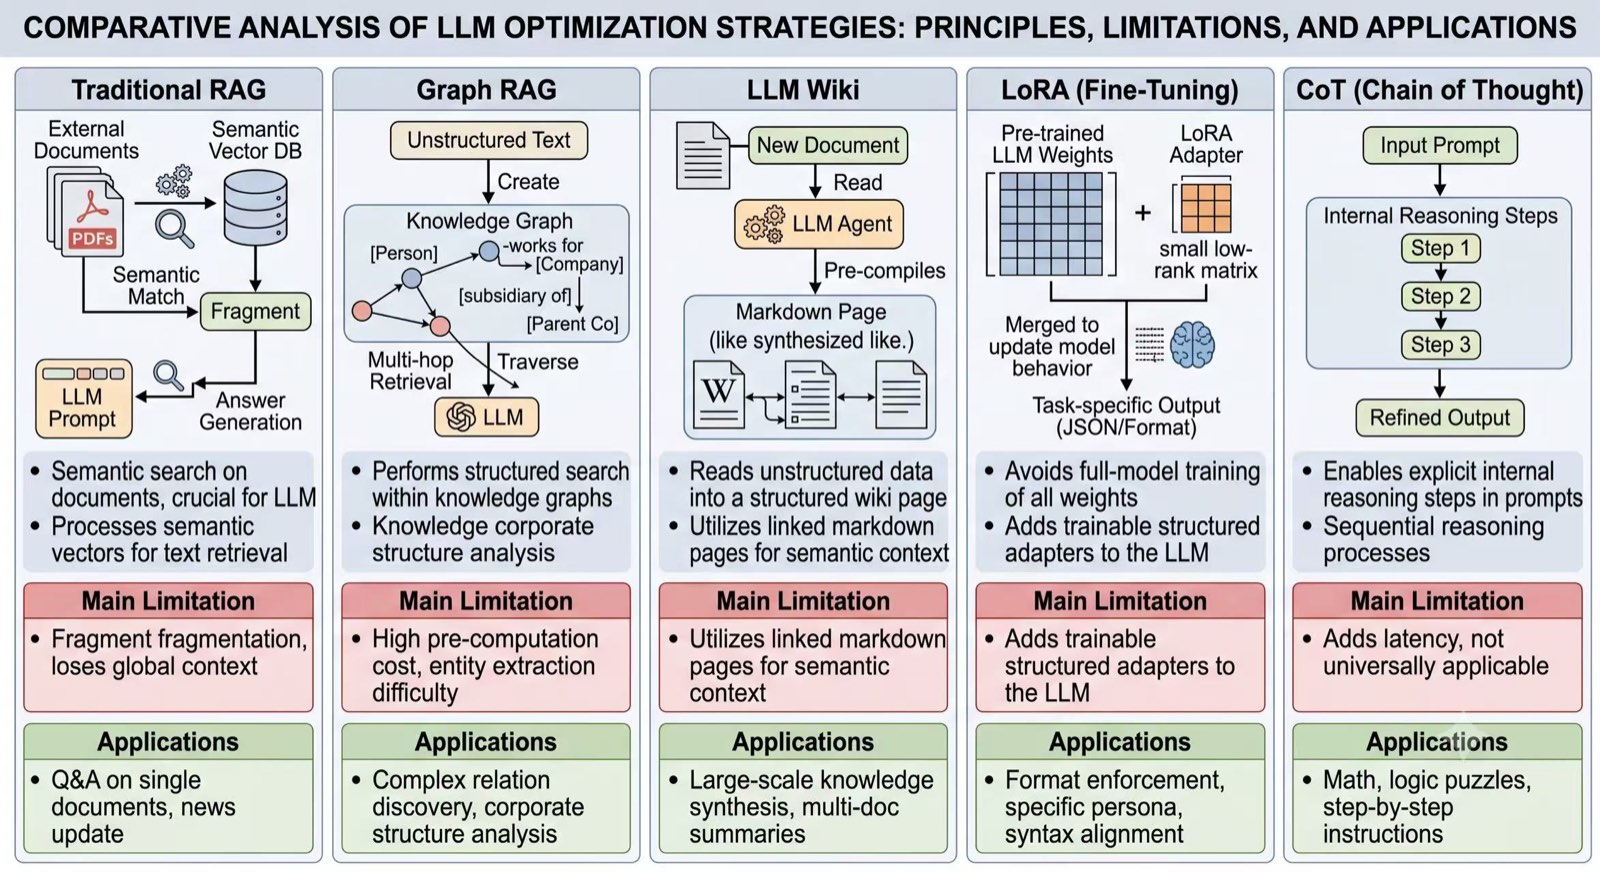
「我让 Gemini 画了一个简图,大家参考,未必是对的,因为我对大模型的理解也很肤浅。」 —— Jeff
这句谦辞值得认真对待,但不是因为图错得离谱——恰恰相反,这张图把 2026 年「让模型用上私有知识」的主要技术路线,压进了一屏:传统 RAG、Graph RAG、LLM Wiki、LoRA 微调、思考链(CoT)。五栏并排,每栏三层:原理、主要局限、应用场景。对刚入门的人来说,这是一张极好的地图。
而 Jeff 自己留了个口子:「以上是我基于我之前的经验的理解,不一定对,让 Arthur 用 AI 去批判性解释会更好。」这篇就是那个批判性版本——先把图讲透,再指出图里三处需要打问号的地方。
先看 Jeff 的原话
图只是配菜,那段文字才是主菜。它提出了一个很硬的框架:
「定义利用知识库和 AI 让输出更加专业有两个维度:1. AI 输出的结果精准不精准,2. 输出的方式是不是合理。这两者都和大模型无关,取决于知识库构建的方法和 LORA 设计本身。」 —— Jeff
这一刀切得很准。市面上绝大多数「AI 效果不好」的抱怨,其实混淆了这两个维度:答得不对(事实、精度问题)和答得不像样(格式、口吻、结构问题)。前者是知识供给问题,后者是行为塑造问题——用错药是常态。他接着解释了这两条线各归谁管:
「LORA 的本质是微调模型的输出,让其收窄到一定规范下,例如输出的口吻、输出的形式(例如 JSON),所以改变的是输出的方式,这个和质量无关……你让他写程序,他跑出来的都是代码,这个就是 LORA;你让他输出 TypeScript 他就输出 TypeScript,而不是 C++。」 —— Jeff
「LORA 本身是外挂一个权重矩阵,通过触发某一个特定领域,将这个权重矩阵和原大模型矩阵相加,强行改变某一块的维度权重的方式改变输出。」 —— Jeff
第二段是标准且准确的 LoRA 描述:原模型权重冻结不动,旁挂一对小矩阵,推理时把它们的乘积加回主权重上。这也是为什么 LoRA 文件常常只有几十 MB,而底座模型有几十 GB。
然后是知识那条线,也是这张图真正的主干:
「输出好不好源头还是在于知识。大模型靠的是预训练里面的知识,维度太广了,所以不够精准,或者权重是普适的,不够聚焦,这个时候需要外挂知识库……但是传统的 RAG 有问题就是碎片化,GRAPH RAG 则是通过知识图谱增强,让知识构建出一个网络。但是太重,所以有了最新的 LLM WIKI 的方式,先建立索引,让 AI 去读索引,让他按照索引去建立知识之间的关联。」 —— Jeff
「但其本身仍然是有限制的:节点之间的关联是通过文本或者关键词,但关键词和关键词之间的逻辑关系是什么?这个时候就需要 COT(思考链),这个是通过 Agent 工程来建立的。」 —— Jeff
注意这段的叙事结构:它不是五个并列选项,而是一条演化链——RAG 碎片化 → GraphRAG 补关联但太重 → LLM Wiki 用索引换成本 → 索引只有关键词没有逻辑 → 用 CoT/Agent 补逻辑。图把它画成了并排的五栏,其实丢掉了这个因果顺序。看图时请把它读成一条时间线,而不是一张菜单。
逐栏拆开:图上写了什么,实际是什么
图上说:外部文档 → 向量化 → 语义匹配 → 取出片段 → 拼进提示词 → 生成答案。局限是「片段碎片化,丢失全局上下文」,适合单文档问答、新闻更新。
这是准确的。补一句图上没画的:RAG 的成败八成不在检索算法,而在切块(chunking)。同一份合同,按 500 字硬切和按条款结构切,召回质量差一个量级。群里上一轮讨论中「感觉 RAG 效果不好」的判断,多半就撞在这里——不是 RAG 不行,是没调对知识库的形态与 embedding 方式。
图上说:非结构化文本 → 抽取实体与关系建成知识图谱([人物]-works for-[公司]-subsidiary of-[母公司])→ 多跳检索、图谱遍历 → 喂给 LLM。局限是「预计算成本高、实体抽取难」。
这一栏画得最见功力。它解决的是普通 RAG 死活答不了的一类问题:「把这批文档整体总结一下」「A 和 D 之间有没有关系」——这类问题没有任何单一片段能命中,必须靠结构。代价是 Jeff 说的「太重」:一份语料要先跑一遍全量实体与关系抽取,几百页文档就是可观的 token 账单,而且文档一改,图谱要重建。它适合相对静态、关系密集的语料:企业股权结构、案卷、病历、供应链。日更的资料库上 GraphRAG,基本是在烧钱。
图上说:新文档 → LLM Agent 预先读一遍 → 预编译成互相链接的 Markdown 页面(像一部合成出来的维基)→ 检索时靠链接导航。适合大规模知识合成、多文档摘要。
先说实话:「LLM Wiki」目前不是一个有定论的学术术语,它是 2025 年以来一类做法的统称——把语料预先「读熟」,产出一套人类和模型都能读的结构化 Markdown 页面与索引,然后让 Agent 像人翻百科一样逐级导航,而不是靠向量近似。同类实践你可能见过别的名字:代码库自动生成的 repo wiki、给 Agent 预备的「上下文包」、以及各种把索引本身当成一等公民的方案。
它的聪明之处在于把成本从「每次查询」挪到了「一次预处理」,而且产物是纯文本——可以被人审阅、被 git 管理、出错能直接改。这对企业落地是个被低估的优势:向量库里的数字没人看得懂,Markdown 页面谁都能校对。它的软肋 Jeff 点得很准:索引里的链接是靠文本和关键词连起来的,链接说明「A 和 B 有关」,但说不出「A 为什么导致 B」。
图上说:预训练权重 + 一个小的低秩矩阵(LoRA 适配器)→ 合并后改变模型行为 → 产出任务专用的输出(JSON / 特定格式)。避免全量训练。适合格式强制、特定人设、语法对齐。
技术描述没问题。但这一栏是全图最容易被误读的地方,下一节专门说。
图上说:输入提示 → 内部推理步骤 1/2/3 → 精炼后的输出。局限是「增加延迟,并非普遍适用」,适合数学、逻辑谜题、分步指令。
这栏的内容是对的,但它和前四栏根本不是同一类东西——详见下一节。
三处需要打问号的地方
Jeff 自己说了「未必是对的」。作为回应,这里是我用 AI 反复核对后,认为最值得校准的三点。这不是挑刺——知道一张 AI 生成的图会在哪里失真,比记住图上的内容更有长期价值。
仔细看第三栏和第四栏的红色「Main Limitation」框:LLM Wiki 那栏写的是「Utilizes linked markdown pages for semantic context」,LoRA 那栏写的是「Adds trainable structured adapters to the LLM」——这两句都是从各自上方蓝色「原理」框里原样复制下来的,把优点当成了缺点填进去。这是当前图表类生成模型的典型故障:版式对、字体对、逻辑框架对,但格子里的内容会串。
它们真正的局限应该是:LLM Wiki——预处理一次性成本高,语料更新后索引会过期,且合成过程本身可能引入模型的幻觉;LoRA——容量有限装不下大量新事实,训练不当会「灾难性遗忘」损伤通用能力,知识一变就得重训。
Jeff 说 LoRA「改变的是输出的方式,这个和质量无关」。作为选型直觉,这句话非常有用,也确实是 LoRA 最擅长、最划算的用法。但严格说:LoRA 也能注入知识,只是效率差、代价高——它会挤占有限的低秩容量,学到的事实容易和原有能力打架,更新一次就要重训一次。所以结论应该是「能用知识库解决的,别用 LoRA 解决」,而不是「LoRA 学不会知识」。
同样地,「Codex、Claude Code 强,一方面是模型强,另一方面其实就是微调很强……这个就是 LORA」——方向对,机制上是简化了。这类编程模型的行为主要来自后训练的完整流程:大规模代码数据的继续预训练、指令微调、基于可验证结果的强化学习(跑测试、看编译是否通过)、以及工具调用与长程任务的专项训练。LoRA 是这套流水线里可能用到的一种参数高效手段,不是它们变强的原因本身。
前四栏回答的是「知识从哪来」——外挂检索、图谱、预编索引、写进权重。CoT 回答的是「拿到知识后怎么推」。把它们并排画成五个可选项,容易让人以为要在「上 GraphRAG」和「上 CoT」之间二选一,而实际上它们是叠加关系:Agentic RAG 就是 CoT × RAG 的乘积。
还有个时效问题:2022 年 CoT 是要靠提示词手动诱导的技巧(「让我们一步步思考」),而到 2026 年,主流推理模型已经把它训进了模型内部,你不写它也会推。今天更值得关心的不再是「要不要 CoT」,而是推理预算怎么花——什么时候值得让模型多想几轮、多查几次,什么时候直接答更划算。这已经是 Agent 工程的范畴,这一点上 Jeff 的原话(「这个是通过 Agent 工程来建立的」)比图更准。
先搞懂几个词
如果上面有词看不懂,这里是最短的解释:
- Chunking(切块)
- 把长文档切成小段再入库。切法决定 RAG 的上限:按语义结构切(条款、章节、问答对)远好于按固定字数硬切。
- 知识图谱 / Knowledge Graph
- 用「实体—关系—实体」三元组表示知识的网络,例如「张三—任职于—A 公司—子公司—B 集团」。它能回答需要跨多步串联的问题。
- 多跳检索(Multi-hop)
- 一个问题需要连续查好几步才能答。「A 公司的母公司的法务负责人是谁」就要跳三次——普通向量检索通常在第二跳就断了。
- 低秩(Low-Rank)
- LoRA 里的「LoRA」。用两个瘦长的小矩阵相乘去近似一个巨大的权重改动,参数量可以只有原来的千分之一,效果却够用。
- 灾难性遗忘
- 微调时模型学会了新任务,却把原本会的通用能力弄丢了。这是所有微调方案挥之不去的风险。
- CoT(Chain of Thought,思考链)
- 让模型把推理过程一步步显式写出来再给结论。对数学、逻辑、多步任务提升明显,代价是更慢更贵。
- Agentic RAG
- 不再是「检索一次、回答一次」,而是让模型自己决定:要不要查、查什么、看完结果要不要换个问法再查一轮,直到自认为够了。
- Ontology(本体)
- 给一个领域定义清楚有哪些对象、有哪些属性、对象之间是什么关系、能对它们做哪些操作。相当于给企业的知识画一张「世界的结构图」。
Jeff 埋的那条线:Palantir 与 Ontology
「要想理解知识库、LORA 在特定领域知识的精准掌握和输出,建议关注 Palantir 这家公司,目前方法论层面做的最好的,通过 ontology 来对企业私有知识或者数据库建模,建立思考链。」 —— Jeff
这是整段话里最容易被划过去、但含金量最高的一句。Palantir 的做法反过来说明了前面五栏共同的短板:它不先想怎么检索,而是先想怎么把企业的世界建模清楚——订单、设备、客户、工单是什么对象,它们之间是什么关系,每个对象上能执行什么动作。这层本体建好之后,AI 不是在文本堆里捞相似段落,而是在一张有明确语义的结构上走路;「思考链」也就有了可依附的骨架,而不是在关键词之间猜逻辑。
这条线和俱乐部下一场要讲的 FDE(前沿部署工程师)是同一件事的两面——FDE 这个岗位最早正是 Palantir 发明的:工程师钻进客户的业务里,把这层模型和真实流程对上。技术选型只是这件事的后半程,前半程是把业务本身想清楚。
群里的接力:我们能参与哪几个
图发出来一个多小时后,一树空山接了两句,正好构成这场讨论的落点。第一句是对上一篇里「本地 embedding + 向量索引 + 本地大模型」的回应:
「我现在做的比这个更进一步,应该算 Agentic RAG。」 —— 一树空山
第二句更关键,直接指着这张图:
「我们基本上只能参与前三个。」 —— 一树空山
「是的[强]」 —— Jeff
这是一句极清醒的自我定位。前三栏(RAG、GraphRAG、LLM Wiki)都是「数据侧」的工程——不碰模型权重,靠切块、建图、建索引、设计检索策略取胜,一台机器、一份语料、一个周末就能做出可用的东西,出了问题也查得清。后两栏(LoRA、CoT)在 2026 年的现实里,主动权已经不在应用方手上:LoRA 要 GPU、要标注数据、要评测体系,成本和门槛都不在同一量级;CoT 则早已被模型厂商训进了底座,轮不到我们再去「加」。
所以这场讨论真正的结论,不是五条路哪条最好,而是:对绝大多数本地企业和独立开发者,前三条路的组合空间已经足够大,而且远没有被挖尽。
那到底怎么选
把上面所有内容压成一张可以直接用的决策表:
不准 → 全部力气花在知识侧(切块、检索、索引、图谱)。不像样 → 先试提示词和输出模板(JSON Schema、结构化输出),实在压不住、量又大,再考虑 LoRA。顺序反了,会花十倍的钱办同一件事。
问答型、单文档能命中 → 传统 RAG 就够。关系密集、需要跨文档串联、语料相对静态 → 值得上 GraphRAG。语料大、需要全局理解、又受不了图谱的重 → LLM Wiki 式的预索引。日更的语料,别碰重预处理方案。
不管选了哪条,最后都需要让模型自己决定查几轮、怎么换问法——也就是 Agentic RAG。这一步的收益,通常比把向量库从 A 换成 B 大得多。
Palantir 那条线的启示:如果你连自己业务里有哪些对象、什么关系都说不清,任何检索方案都只是在混乱之上加一层混乱。
写在最后
这篇的缘起,其实是前一天早上群里的一段对话。有成员夸「这个群交流内容整理真不错」,Arthur 提到正是 Jeff 建议:把术语摘出来解释 + 群聊内容精华 + AI 深入探讨,这样深入浅出形成一套逻辑,方便不同程度的群友,也是对讨论知识的积累。
然后当天中午,Jeff 自己就贡献了最好的一篇原料,还主动说「不一定对,让 Arthur 用 AI 去批判性解释会更好」。一个愿意把自己的判断交出来被质疑的人,和一群愿意认真质疑的人——这大概就是这个群最值钱的地方。